OCR coreano/inglês · beta
OCR coreano/inglês · beta — Extraia o texto da imagem para TXT/JSON
Reconheça coreano ou inglês em uma imagem, revise o texto e salve TXT ou JSON sem enviar o arquivo. Converta primeiro as páginas de um PDF digitalizado em imagens.
- Selecionar uma imagem
- Verificar idioma e mecanismo e reconhecer
- Revisar o texto reconhecido e salvar TXT ou JSON
Exemplo de uso
- Entrada de exemplo
scan.png- Motor de OCR
PaddleOCR · coreano + inglês- Resultado esperado
TXT + JSON · PaddleOCR [review text]
Os exemplos são ilustrativos. Os resultados reais dependem do arquivo original e das configurações.
Como extrair texto de fotos e PDFs digitalizados?
Este OCR recebe uma imagem por vez. Primeiro converta as páginas necessárias do PDF digitalizado em imagens. Experimente PaddleOCR para coreano e inglês ou selecione Tesseract. Revise e corrija o texto reconhecido antes de salvar TXT e JSON.
Manuscritos, letras pequenas, documentos inclinados e a estrutura de tabelas podem ser reconhecidos incorretamente. Extrair TXT é diferente de criar um PDF pesquisável. O primeiro uso baixa um mecanismo e pode demorar mais.
PDF para imagensCompare a entrada e o resultado
Registro anterior de OCR com um documento sintético. Confira espaços e números no original antes de salvar. A precisão e a velocidade não são garantidas para outros documentos.
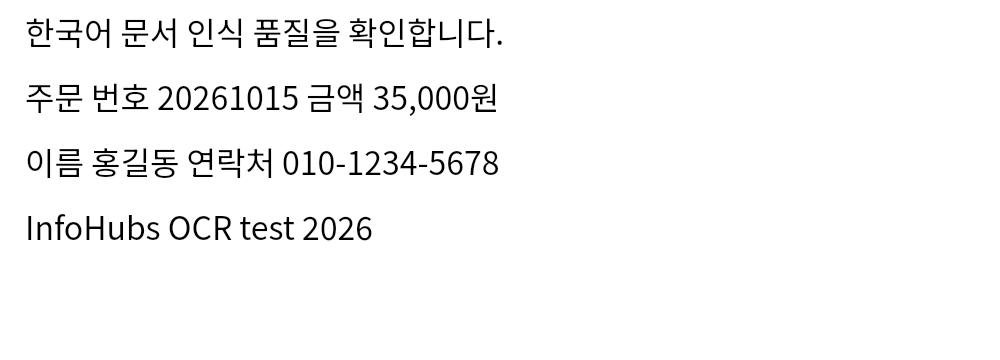
Resultado · Tesseract
한국어 문서 인식 품 질 을 확 인 합 니다.
주문 번호 20261015 금액 35,000 원
이름 홍길동 연락처 010-1234-5678
InfoHubs OCR test 2026
Salvar imagem · Salvar TXT reconhecido · JSON ·
Se o resultado não for o esperado
- Faltam letras ou os números estão errados
- Endireite e recorte o documento; confira sombras e letras pequenas. Compare outro mecanismo com a mesma imagem e confira números, valores e espaços no original. Tabelas e manuscritos não são garantidos.
- A preparação demora ou para
- O primeiro uso baixa um mecanismo. Confira o progresso e a conexão e tente uma imagem menor. Se continuar, preserve o original e envie apenas a mensagem de erro e informações do navegador.
Exemplos e limitações
Aceita imagens em coreano e inglês. Exporte primeiro as páginas do PDF digitalizado como imagens e compare o texto com o original.
Entrada e saída
- Entrada compatível
.jpg · .jpeg · .jfif · .png · .apng · .webp · .gif · .bmp · .tif · .tiff · .ico · .heic · .heif · .avif · .svg- Saída salva
TXT · JSON
Limites e verificações
- Uma imagem · 30 MB · 12 MP · 3 minutos. PaddleOCR (coreano e inglês) ou Tesseract roda no dispositivo. Download inicial deste site: cerca de 66 MB ou 22 MB. Nenhum arquivo é enviado. Revise e corrija o texto. Não há garantia para manuscritos, documentos inclinados ou tabelas.