한국어·영어 OCR · 베타
한국어·영어 OCR · 베타 — 이미지 글자를 TXT·JSON으로
이미지 한 장의 한국어·영어 글자를 인식해 수정한 뒤 TXT·JSON으로 저장합니다. 파일은 업로드하지 않습니다. 스캔 PDF는 필요한 쪽을 먼저 이미지로 변환하세요.
- 이미지 한 장 선택
- 지원 언어·엔진 확인 후 인식
- 인식 내용을 확인하고 TXT·JSON 저장
사용 예시
- 예시 입력
scan.png- OCR 엔진
PaddleOCR · 한국어 + 영어- 예상 결과
TXT + JSON · PaddleOCR [review text]
예시는 설명용입니다. 실제 결과는 원본 파일과 설정에 따라 달라집니다.
스캔 PDF와 사진에서 글자를 추출하려면?
이 OCR의 입력은 이미지 한 장입니다. 스캔 PDF는 먼저 PDF 이미지 변환으로 필요한 쪽을 이미지로 저장한 뒤 선택하세요. 한국어·영어 문서는 PaddleOCR로 시도하고 추출한 내용을 수정한 뒤 TXT 또는 JSON으로 저장하세요.
표의 행·열 구조, 손글씨, 기울어진 문서는 정확성을 보장하지 않습니다. 검색 가능한 PDF가 필요한 작업과 TXT 추출은 다릅니다. 첫 사용에는 엔진 다운로드와 실행 대기가 있습니다.
PDF → 이미지입력과 결과를 직접 비교하세요
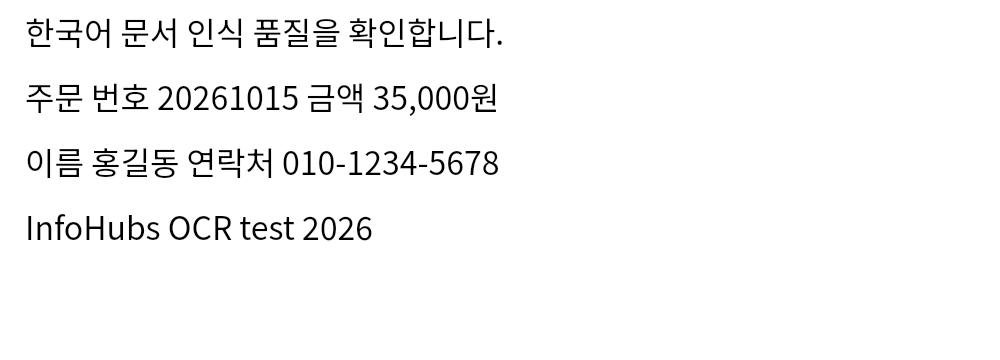
합성 문서의 기존 OCR 실행 기록입니다. 띄어쓰기와 숫자를 원본과 비교한 뒤 저장하세요. 정확도나 처리 시간을 모든 문서에 보장하지 않습니다.
결과 · Tesseract
한국어 문서 인식 품 질 을 확 인 합 니다.
주문 번호 20261015 금액 35,000 원
이름 홍길동 연락처 010-1234-5678
InfoHubs OCR test 2026
이미지 저장 · 인식 TXT 저장 · JSON ·
결과가 예상과 다를 때
- 글자가 빠지거나 숫자가 달라요
- 문서를 반듯하게 자르고 그림자·작은 글자를 확인하세요. 같은 이미지로 다른 엔진도 비교하고 숫자·금액·띄어쓰기는 원본과 직접 대조하세요. 표 배치와 손글씨는 보장하지 않습니다.
- 준비 단계가 오래 걸리거나 멈췄어요
- 첫 실행에는 엔진 다운로드가 필요합니다. 진행 상태와 네트워크를 확인하고 더 작은 이미지 한 장으로 다시 시도하세요. 계속 실패하면 원본을 보관한 뒤 오류 문구·브라우저 정보만 문의해주세요.
예시·주의사항 보기
한국어·영어 이미지를 지원합니다. 스캔 PDF는 먼저 쪽을 이미지로 변환하세요. 인식 결과는 원본과 대조해야 합니다.
입출력 조건
- 지원 입력
.jpg · .jpeg · .jfif · .png · .apng · .webp · .gif · .bmp · .tif · .tiff · .ico · .heic · .heif · .avif · .svg- 저장 결과
TXT · JSON
제한 및 확인사항
- 이미지 1장 · 30 MB·12 MP · 3분. PaddleOCR 한국어·영어 또는 기존 Tesseract를 기기에서 실행합니다. 첫 사용 시 PaddleOCR 약 66 MB, Tesseract 약 22 MB를 이 사이트에서 내려받습니다. 파일은 업로드하지 않습니다. 결과를 수정한 뒤 저장하세요. 손글씨·기울어진 문서·표 복원 정확도는 보장하지 않습니다.