OCR coreano/inglés · beta
OCR coreano/inglés · beta — Extraer texto de imagen a TXT/JSON
Reconoce coreano o inglés en una imagen, revisa el texto y guarda TXT o JSON sin subir el archivo. Convierte primero las páginas de un PDF escaneado a imágenes.
- Seleccionar una imagen
- Comprobar idioma y motor e iniciar el reconocimiento
- Revisar el texto reconocido y guardar TXT o JSON
Ejemplo de uso
- Entrada de ejemplo
scan.png- Motor OCR
PaddleOCR · coreano + inglés- Resultado esperado
TXT + JSON · PaddleOCR [review text]
Los ejemplos son ilustrativos. Los resultados reales dependen del archivo original y de los ajustes.
¿Cómo extraer texto de fotos y PDF escaneados?
Este OCR recibe una imagen cada vez. Convierte primero las páginas necesarias del PDF escaneado en imágenes. Prueba PaddleOCR para coreano e inglés o selecciona Tesseract. Revisa y corrige el texto reconocido antes de guardar TXT y JSON.
La escritura manual, los caracteres pequeños, los documentos inclinados y la estructura de tablas pueden reconocerse mal. Extraer TXT no es lo mismo que crear un PDF con búsqueda. El primer uso descarga un motor y puede tardar más.
PDF a imágenesCompara la entrada y el resultado
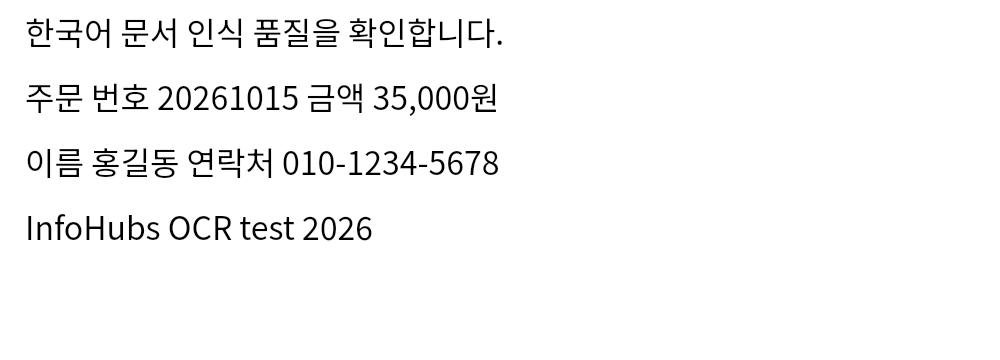
Registro previo de OCR con un documento sintético. Compara espacios y números con el original antes de guardar. No se garantiza la precisión ni la velocidad con otros documentos.
Resultado · Tesseract
한국어 문서 인식 품 질 을 확 인 합 니다.
주문 번호 20261015 금액 35,000 원
이름 홍길동 연락처 010-1234-5678
InfoHubs OCR test 2026
Guardar imagen · Guardar TXT reconocido · JSON ·
Si el resultado no es el esperado
- Faltan letras o los números son incorrectos
- Endereza y recorta el documento; revisa sombras y letras pequeñas. Compara otro motor con la misma imagen y contrasta números, importes y espacios con el original. No se garantizan tablas ni escritura manual.
- La preparación tarda demasiado o se detiene
- El primer uso descarga un motor. Revisa el progreso y la conexión, y prueba una imagen más pequeña. Si persiste, conserva el original y envía solo el mensaje de error y la información del navegador.
Ejemplos y limitaciones
Admite imágenes en coreano e inglés. Exporta primero las páginas del PDF escaneado como imágenes y comprueba el texto con el original.
Entrada y salida
- Entrada compatible
.jpg · .jpeg · .jfif · .png · .apng · .webp · .gif · .bmp · .tif · .tiff · .ico · .heic · .heif · .avif · .svg- Salida guardada
TXT · JSON
Límites y comprobaciones
- Uma imagen · 30 MB · 12 MP · 3 minutos. PaddleOCR (coreano e inglés) o Tesseract se ejecuta en tu dispositivo. Descarga inicial desde este sitio: unos 66 MB o 22 MB. No se suben archivos. Revisa y corrige el texto. No se garantiza la lectura de manuscritos, documentos inclinados ni tablas.