韩文/英文OCR·测试版
韩文/英文OCR·测试版 — 提取图像文本到 TXT / JSON
识别一张图片中的韩文或英文,检查并修改后保存TXT或JSON。文件不会上传。扫描PDF请先将所需页面转换为图片。
- 选择一张图片
- 确认语言和引擎后识别
- 检查识别结果并保存 TXT 或 JSON
使用示例
- 示例输入
scan.png- OCR 引擎
PaddleOCR · 韩语 + 英语- 预期结果
TXT + JSON · PaddleOCR [review text]
示例仅用于说明。实际结果取决于源文件和设置。
如何从扫描PDF和照片中提取文字?
此OCR一次接收一张图片。请先用PDF转图片工具将扫描PDF中需要的页面保存为图片。韩文和英文可先尝试PaddleOCR,也可选择Tesseract。识别后检查并修改文字,再保存TXT和JSON。
手写、小字、倾斜文档和表格结构可能无法准确识别。提取TXT不同于创建可搜索PDF。首次使用需要下载引擎,准备时间可能较长。
PDF 转图像比较输入与结果
这是合成文档的既有OCR运行记录。保存前请对照原文检查空格和数字。不保证其他文档的准确率或速度。
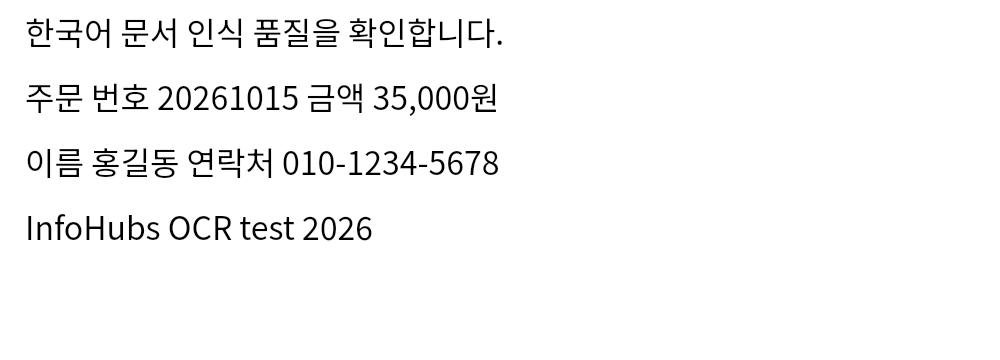
结果 · Tesseract
한국어 문서 인식 품 질 을 확 인 합 니다.
주문 번호 20261015 금액 35,000 원
이름 홍길동 연락처 010-1234-5678
InfoHubs OCR test 2026
保存图片 · 保存识别TXT · JSON ·
结果与预期不同时
- 漏字或数字错误
- 校正文档倾斜并裁剪,检查阴影和小字。用同一图片比较其他引擎,并对照原件核对数字、金额和空格。不保证表格和手写识别效果。
- 准备过久或停止
- 首次使用需要下载引擎。检查进度和网络,再用一张较小图片重试。若仍失败,请保留原件,联系时只提供错误提示和浏览器信息。
示例和限制
支持韩文和英文图片。请先将扫描 PDF 页面转为图片,并将识别结果与原图对照。
输入和输出条件
- 支持的输入
.jpg · .jpeg · .jfif · .png · .apng · .webp · .gif · .bmp · .tif · .tiff · .ico · .heic · .heif · .avif · .svg- 保存的输出
TXT · JSON
限制和检查事项
- 单张图片 · 30 MB · 12 MP · 3分钟。PaddleOCR(韩语和英语)或 Tesseract 在本机运行。首次从本站下载约66 MB或22 MB,不上传文件。保存前请检查和修改结果。手写、倾斜文档和表格还原不保证准确。