韓国語/英語OCR・ベータ版
韓国語/英語OCR・ベータ版 — 画像テキストをTXT / JSONに抽出します
画像1枚の韓国語・英語を認識し、修正してTXT・JSONに保存します。ファイルはアップロードしません。スキャンPDFは先に必要なページを画像にしてください。
- 画像を1枚選択
- 対応言語とエンジンを確認して認識
- 認識結果を確認してTXT・JSONで保存
使用例
- 入力例
scan.png- OCRエンジン
PaddleOCR · 韓国語 + 英語- 想定される結果
TXT + JSON · PaddleOCR [review text]
例は説明用です。実際の結果は元のファイルと設定によって異なります。
スキャンPDFや写真から文字を抽出するには?
OCRへの入力は画像1枚です。スキャンPDFは先にPDF画像変換で必要なページを画像にしてから選択します。韓国語・英語はPaddleOCRを試し、必要に応じてTesseractも選べます。認識後に内容を修正してTXT・JSONを保存します。
手書き、小さい文字、傾いた文書、表の構造は正しく認識できない場合があります。TXTの抽出と検索可能なPDFの作成は異なります。初回はエンジンを取得するため時間がかかります。
PDFから画像へ入力と結果を比較する
合成文書を使った既存のOCR実行記録です。保存前に空白と数字を原文と比較してください。他の文書の精度や速度は保証しません。
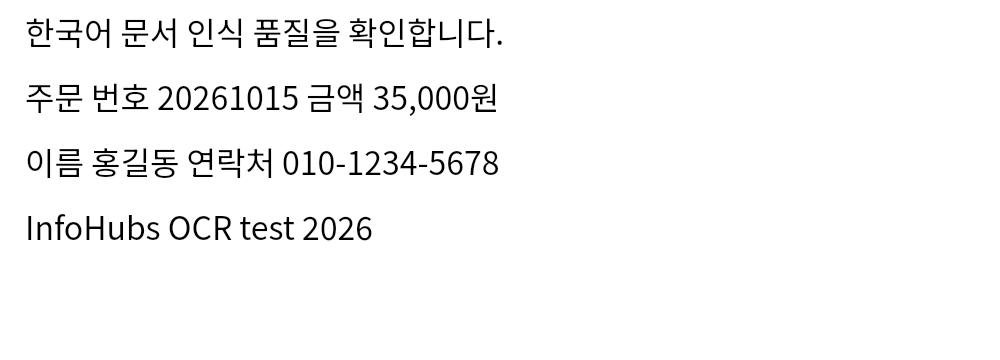
結果 · Tesseract
한국어 문서 인식 품 질 을 확 인 합 니다.
주문 번호 20261015 금액 35,000 원
이름 홍길동 연락처 010-1234-5678
InfoHubs OCR test 2026
画像を保存 · 認識TXTを保存 · JSON ·
結果が予想と違うとき
- 文字が抜ける・数字が違う
- 文書の傾き、影、小さい文字を確認し、必要な範囲を切り抜きます。同じ画像で別のエンジンも比較し、数字・金額・空白を原文と照合してください。表や手書きは保証しません。
- 準備に時間がかかる・止まる
- 初回はエンジンをダウンロードします。進行状況と通信を確認し、小さい画像1枚で再試行してください。改善しない場合は原本を保管し、エラー文とブラウザー情報だけでお問い合わせください。
例と制限事項
韓国語・英語の画像に対応します。スキャンPDFは先にページを画像に変換し、認識結果を原本と比較してください。
入出力条件
- 対応入力
.jpg · .jpeg · .jfif · .png · .apng · .webp · .gif · .bmp · .tif · .tiff · .ico · .heic · .heif · .avif · .svg- 保存形式
TXT · JSON
制限と確認事項
- 画像1枚・30 MB・12 MP・3分。PaddleOCR(韓国語・英語)またはTesseractを端末で実行。初回は約66 MBまたは22 MBを当サイトから取得します。ファイルは送信しません。結果を確認・修正して保存してください。手書き・傾き・表の再現精度は保証しません。